Saltar al contenido
Menú

Apariencia

Idioma

GitHub — @IchiSieben

ingeniero de software para investigación · lima · remoto

Código como oficio. Datos como evidencia.

Construyo pipelines de datos, scrapers y herramientas web para investigación y negocio, y documento las decisiones para que cualquiera pueda auditarlas.

Ver proyectos

13 proyectos · 4 en vivo

Proyectos

Casos de estudio con el código y los números detrás.

En vivo · Usable

Ciencia & bioinformática

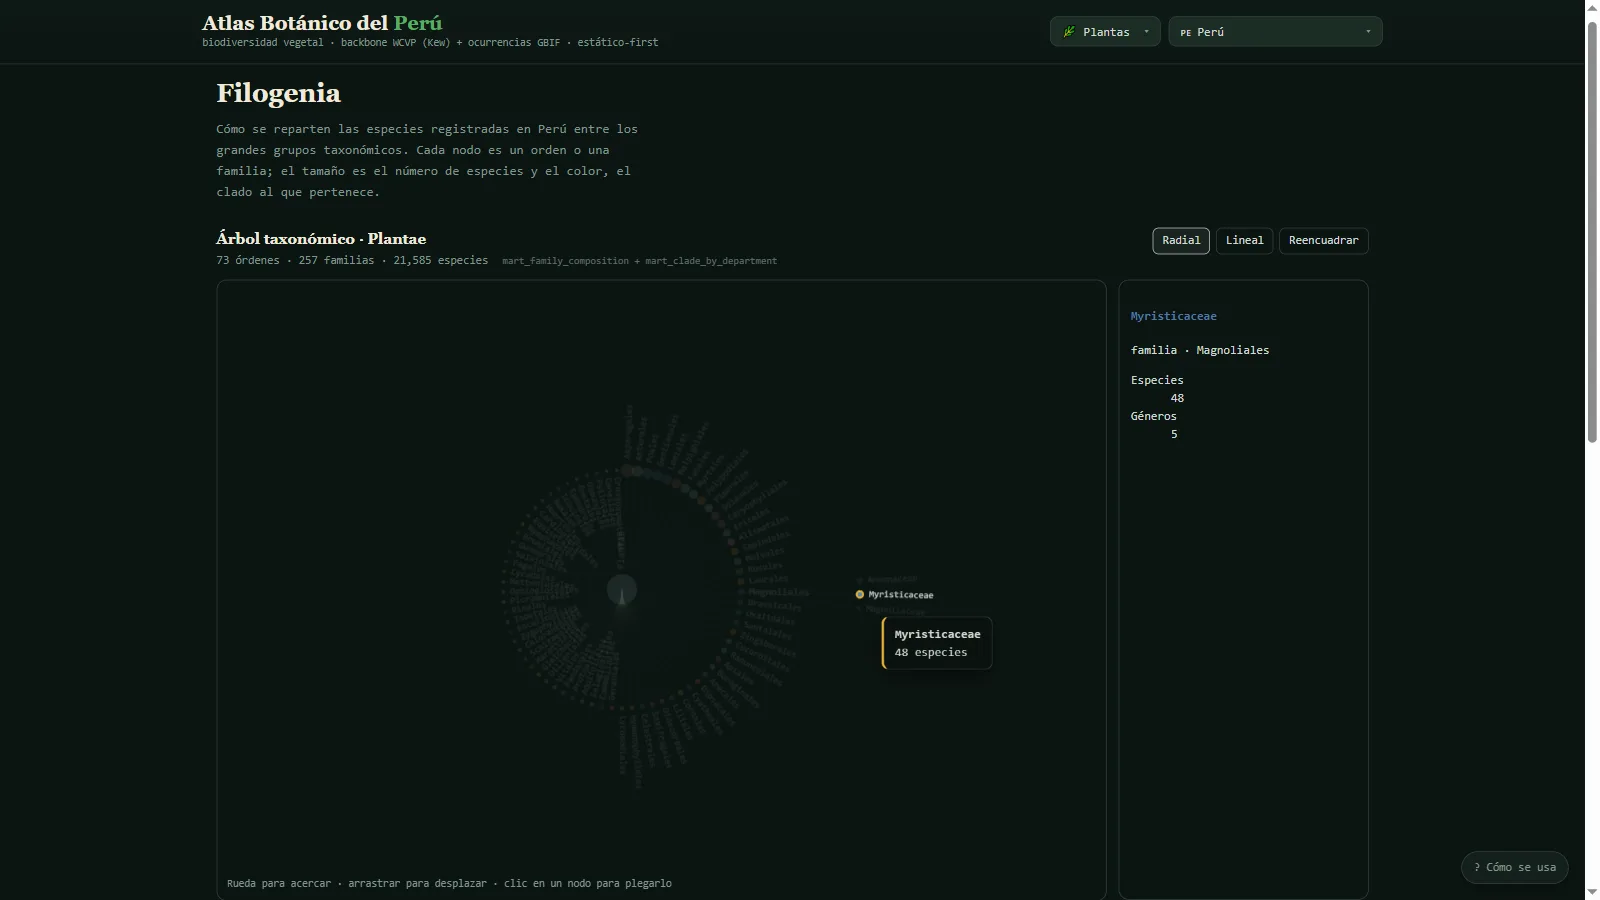
Atlas Botánico del Perú

Convertí datos crudos de GBIF en un árbol con las 21 585 especies de plantas aceptadas del Perú, que se abre en el navegador.

DuckDB · 1,28 M de registros GBIF · ETL de diez etapas · marts estáticos, sin backend
Ver caso de estudio
En vivo · Usable
Las apps gratuitas de Streamlit se duermen si nadie las visita; el primer visitante las despierta, y eso puede tardar cerca de un minuto.

Machine learning & IA

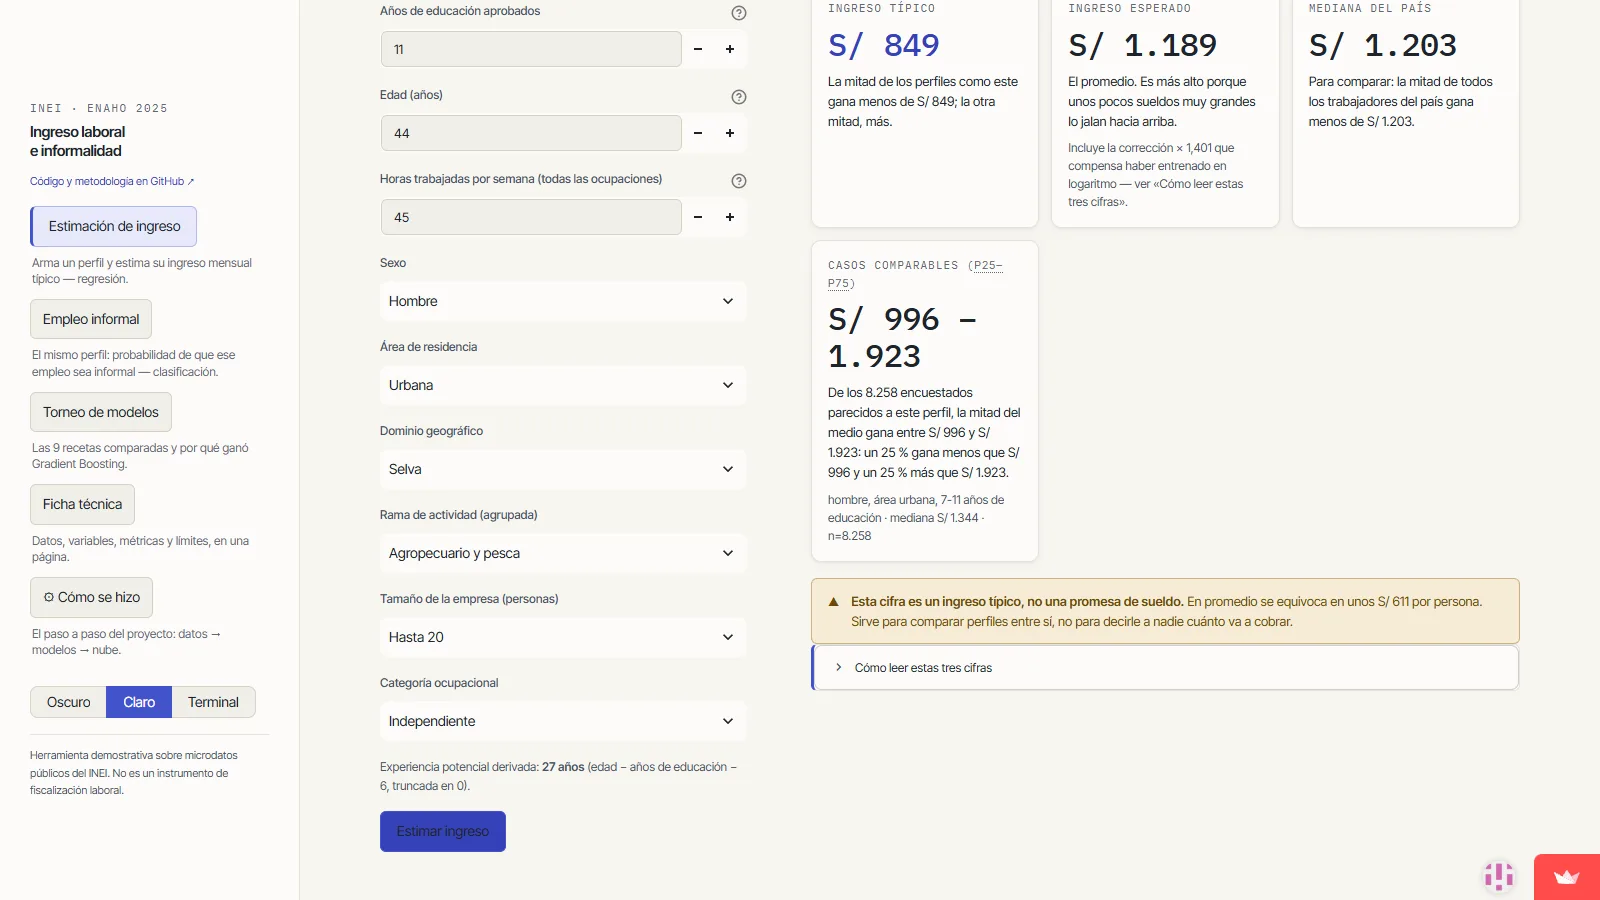
Predictor de Ingresos e Informalidad

Comparé 9 especificaciones de modelo para predecir el ingreso laboral y el riesgo de informalidad en Perú, con la encuesta ENAHO.

scikit-learn · torneo de nueve modelos · intervalos con statsmodels · Streamlit

  • scikit-learn
  • pandas
  • Streamlit
  • ST statsmodels
  • Python
Ver caso de estudio

Ver los 13 proyectos →

En camino a ser público

OpenMetadata Warehouse
En desarrollo · Prototipo

Infraestructura & servidores

OpenMetadata Warehouse

Conecté Claude Code a un servicio de OpenMetadata que corre sobre un warehouse Oracle y SQL Server, para gestionar ingesta, linaje y ciclo de vida del servidor como código.

OpenMetadata · Oracle · SQL Server · Python · Docker

  • OP OpenMetadata
  • OR Oracle
  • SQ SQL Server
  • Python
  • Docker
Ver caso de estudio
Repositorio de Datos Abiertos
En desarrollo · Prototipo

Datos & sector público

Repositorio de Datos Abiertos

Estoy convirtiendo una carpeta de scripts de scraping y limpieza en un catálogo estático que cualquiera puede buscar, previsualizar y usar sin conexión.

Python · SQLite · sitio estático, sin servidor

Workboard
En desarrollo · Prototipo

Web & producto

Workboard

Un tablero estilo Jira: proyectos, épicas, tarjetas, línea de tiempo — hecho para una oficina de TI del sector público.

JavaScript

Ver caso de estudio
Signal Agent
En desarrollo · Prototipo

Agentes & automatización IA

Signal Agent

Un monitor de mercado donde el modelo tiene que escribir una predicción falsable antes de poder ser evaluado — 3 abiertas, 0 resueltas, las primeras vencen en enero de 2027.

Python · GitHub Actions · SQLite

Ver caso de estudio

53 herramientas · una por problema

Stack

Las herramientas que domino, agrupadas por área. La versatilidad no es amontonar frameworks: es elegir el correcto para cada problema.

Ver el mapa →

Lenguajes 06

  • Python 9 proyectos El lenguaje de proposito general para datos, scripting y backends.
  • JavaScript 6 proyectos El lenguaje que corre en el navegador: interactividad sin depender de un backend.
  • SQL 1 proyecto El lenguaje para consultar y modelar datos relacionales.
  • TypeScript 1 proyecto JavaScript con tipos: errores que aparecen al escribir, no en producción.
  • HTML y CSS 1 proyecto La base de cualquier interfaz web, antes de que exista cualquier framework.
  • Bash 1 proyecto El lenguaje de la terminal: automatizar, encadenar comandos y mover archivos sin abrir un editor.

Frameworks 07

  • Astro 2 proyectos Genera sitios estáticos que envían cero JavaScript salvo donde se pide explícitamente.
  • React 1 proyecto Libreria de UI por componentes; la base de casi cualquier frontend interactivo moderno.
  • Streamlit 1 proyecto Convierte un script de Python en una app web interactiva sin escribir frontend.
  • Vite 1 proyecto Build tool y servidor de desarrollo, rápido incluso en proyectos con muchos módulos.
  • Zustand 1 proyecto Manejo de estado mínimo en React, sin el boilerplate de alternativas más pesadas.
  • Tailwind CSS CSS por clases utilitarias: diseñar sin saltar entre archivos de estilos.
  • PyQt6 Interfaces de escritorio en Python, usado cuando la app no puede vivir en un navegador.

Datos 12

  • Apache ECharts 3 proyectos Gráficos interactivos para dashboards con volumen de datos real.
  • SQLite 3 proyectos Base de datos relacional embebida en un solo archivo, sin servidor que administrar.
  • Three.js 2 proyectos 3D en el navegador sobre WebGL, para visualizaciones y escenas interactivas.
  • DuckDB 1 proyecto Motor SQL embebido para analizar archivos grandes (Parquet, CSV) sin levantar un servidor.
  • ETL 1 proyecto Extraer, transformar y cargar datos de una fuente cruda a algo que se puede consultar.
  • pandas 1 proyecto Manipulación de tablas en Python: limpiar, agrupar y transformar datos antes de analizarlos.
  • Oracle 1 proyecto Base de datos relacional usada en sistemas empresariales grandes y con mucha historia.
  • SQL Server 1 proyecto Base de datos relacional de Microsoft, común en sistemas empresariales Windows.
  • Parquet Formato de archivo columnar, comprimido, hecho para analitica sobre grandes volumenes.
  • Polars Alternativa a pandas escrita en Rust, mucho más rápida en datasets grandes.
  • Excel y reportes Reportes y hojas de cálculo cuando el destinatario final vive en Excel, no en un dashboard.
  • MySQL Base de datos relacional de código abierto, la más común en hosting compartido.

Infraestructura & servidores 06

  • OpenMetadata 1 proyecto Catálogo de datos: linaje, ownership y descubrimiento sobre las fuentes de una organización.
  • Docker 1 proyecto Empaqueta una app con todo lo que necesita para correr igual en cualquier maquina.
  • Git Control de versiones: historial, ramas y la base de cualquier flujo de colaboración en código.
  • Hosting estático Servir sitios sin backend: más rápido, más barato y con menos superficie de ataque.
  • Linux El sistema operativo detras de casi todo lo que se despliega en un servidor.
  • Airflow Orquesta pipelines de datos como grafos de tareas con dependencias y reintentos.

Sistemas operativos 02

  • Windows Sistema operativo de escritorio, el entorno de desarrollo y verificación más común.
  • macOS / ARM Compilar y verificar en Apple Silicon, la arquitectura del hardware más reciente de Apple.

Seguridad 02

  • Gestión de secretos Credenciales fuera del repo, siempre por variable de entorno, auditadas antes de publicar.
  • Privacidad de datos Datos sintéticos o públicos en los demos: ninguna persona real identificable.

IA & machine learning 09

  • scikit-learn 1 proyecto Modelos clásicos de machine learning: clasificación, regresión y clustering.
  • LLM y agentes 1 proyecto Modelos de lenguaje orquestados como agentes, con evaluación en el flujo y no en la promesa.
  • statsmodels 1 proyecto Modelos estadísticos clásicos en Python: regresiones con inferencia, no solo predicción.
  • PyTorch Framework de machine learning para entrenar e inferir modelos de deep learning.
  • OpenCV Librería de visión por computadora: detección, transformación y procesamiento de imágenes.
  • InsightFace Detección y reconocimiento facial de código abierto, usado con cuidado por ser dato biométrico.
  • OCR y documentos Convertir documentos escaneados o imagenes en texto que se puede buscar y procesar.
  • Segment Anything (SAM) Modelo de segmentación de imágenes de Meta: recorta cualquier objeto sin entrenamiento previo.
  • Speech-to-text Transcribir audio a texto para buscar, indexar o subtitular contenido hablado.

Scraping & automatización 06

  • Scraping 3 proyectos Extraer datos de APIs no documentadas o HTML, siempre de fuentes legítimas.
  • GitHub Actions 3 proyectos CI/CD alojado en el mismo repo: build, test y deploy en cada push.
  • Matching de entidades 1 proyecto Decidir si dos registros distintos describen la misma entidad, por texto, código o imagen.
  • BeautifulSoup y selectolax 1 proyecto Parsers de HTML para sacar datos de páginas que no tienen API.
  • Playwright Automatiza un navegador real para probar sitios o extraer datos que necesitan JavaScript.
  • Selenium Automatización de navegador para pruebas o scraping cuando el sitio necesita interacción real.

Negocio 03

  • Datos abiertos 2 proyectos Construir con fuentes publicas y citables en vez de datos de cliente.
  • E-commerce 1 proyecto Catálogo, carrito y checkout: la mecánica de una tienda, no solo la vitrina.
  • Visualización de datos Que un catálogo enorme se entienda en 30 segundos: la disciplina de mostrar datos.

el razonamiento, no el discurso

Cómo trabajo

IchiSieben es el nombre de trabajo de Yoichi Palacios Tanaka. Construyo pipelines de datos, scrapers y herramientas web — software que lee una fuente, la limpia y la convierte en algo sobre lo que alguien puede actuar.

Cada proyecto acá sale con las decisiones detrás por escrito: por qué esta base de datos y no otra, qué muestra de verdad la data, qué cambiaría después. No es cortesía — es cómo se verifica el trabajo, por mí o por cualquier otra persona.

Uso IA donde se lo gana: para avanzar más rápido en lo repetitivo, para explorar un dataset, para el primer borrador. El criterio sobre qué construir y si está bien sigue siendo mío, y el README lo dice.

un correo, sin formulario

Contacto

¿Un proyecto, una vacante o una pregunta sobre el stack? Elige la que aplica y te respondo con el contexto correcto.
GitHub @IchiSieben